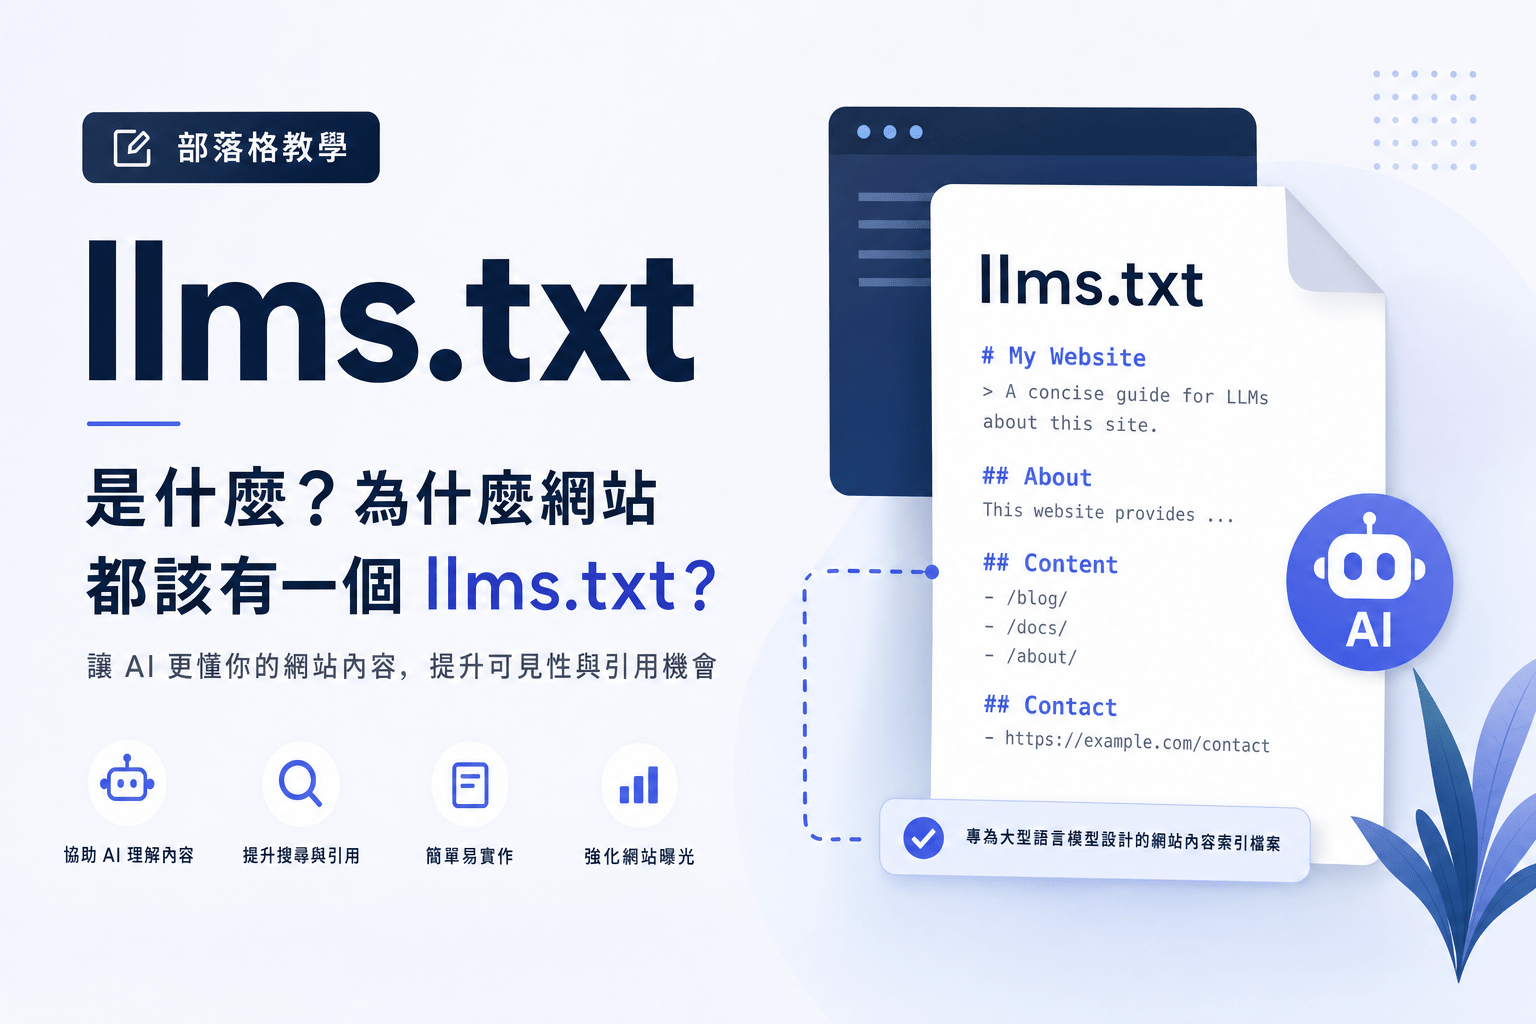
llms.txt 這個檔案最近常被客戶問到,說法是在網站根目錄放一份,ChatGPT 讀網站就會比較順。里揚這半年陸續被問了幾次,所以把目前查得到的事實、適合做的網站類型,以及它實際能帶來什麼,整理成這篇。
llms.txt 是什麼?放在哪、寫給誰讀
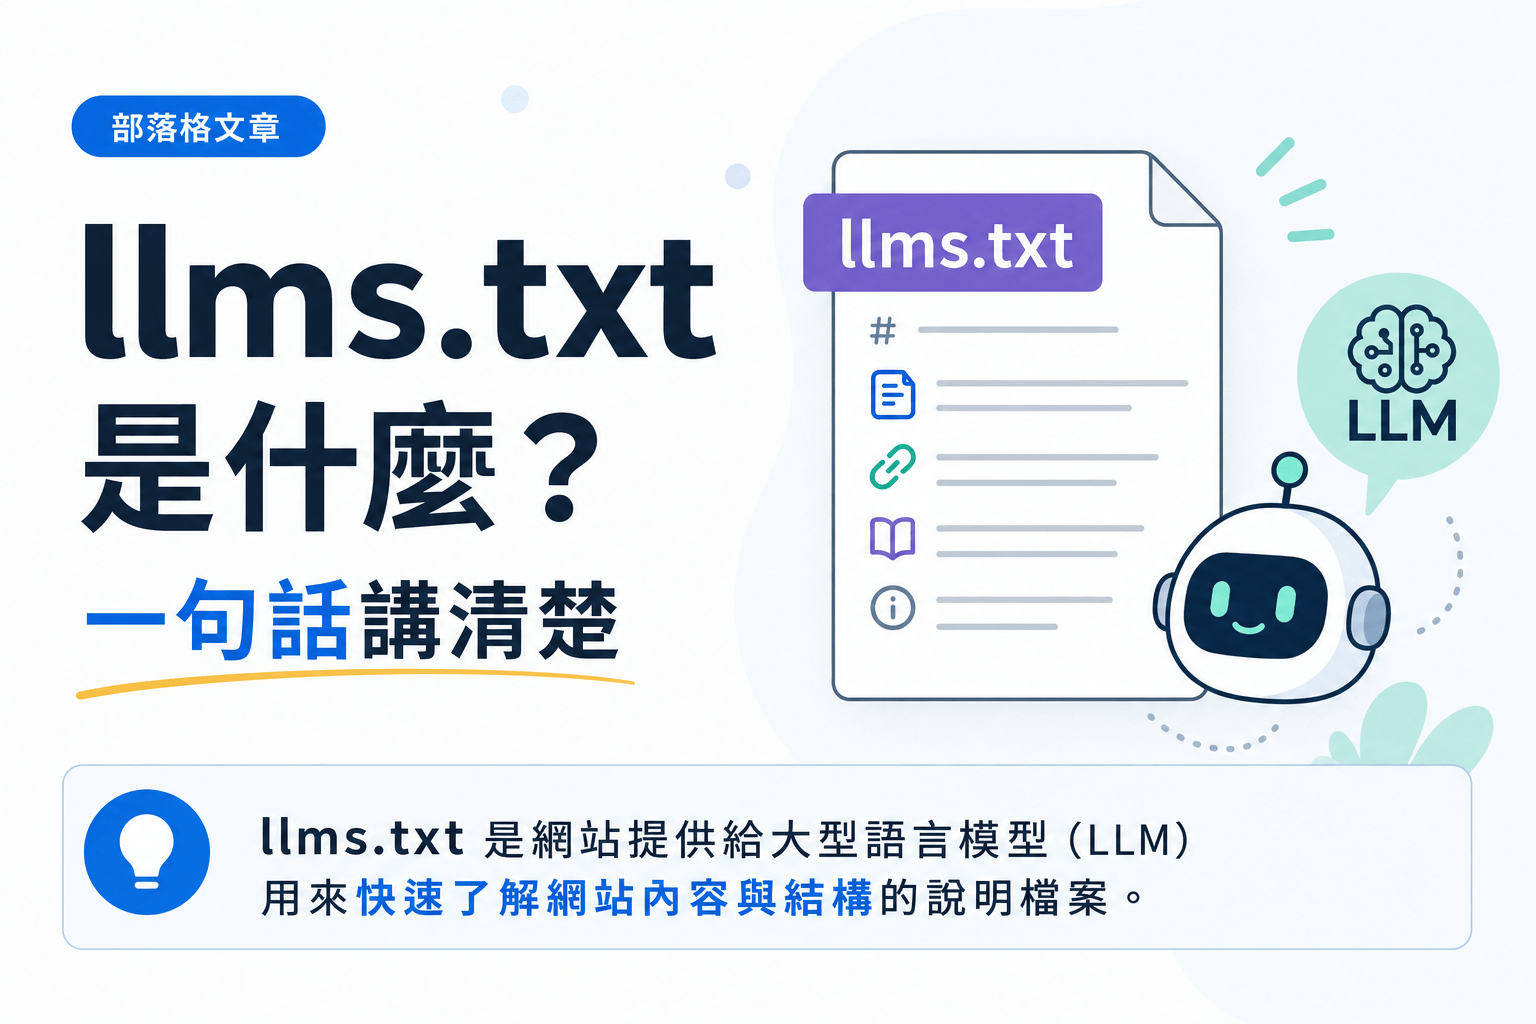
llms.txt 是一份放在網站根目錄的純文字檔,路徑是 /llms.txt,用結構化的寫法告訴大型語言模型這個網站重要的內容在哪,各自又在講什麼。提案人是 Jeremy Howard,2024 年提出,定位接近一份為語言模型準備的索引。
它跟兩個常被混在一起的檔案分工不同:
robots.txt:規定爬蟲哪些頁可以抓,哪些不行,管的是權限。sitemap.xml:給搜尋引擎一份網站的頁面列表。llms.txt:給語言模型一份精選過的內容清單,除了列出頁面,還附上每一頁在講什麼、為什麼值得讀。
要先知道的一件事是它沒有強制力,Google、Anthropic、OpenAI 都沒有承諾會讀 llms.txt,它目前的身分是社群推動的提案,不在 W3C 或 IETF 的規範裡。
llms.txt 跟 robots.txt、sitemap.xml 差在哪
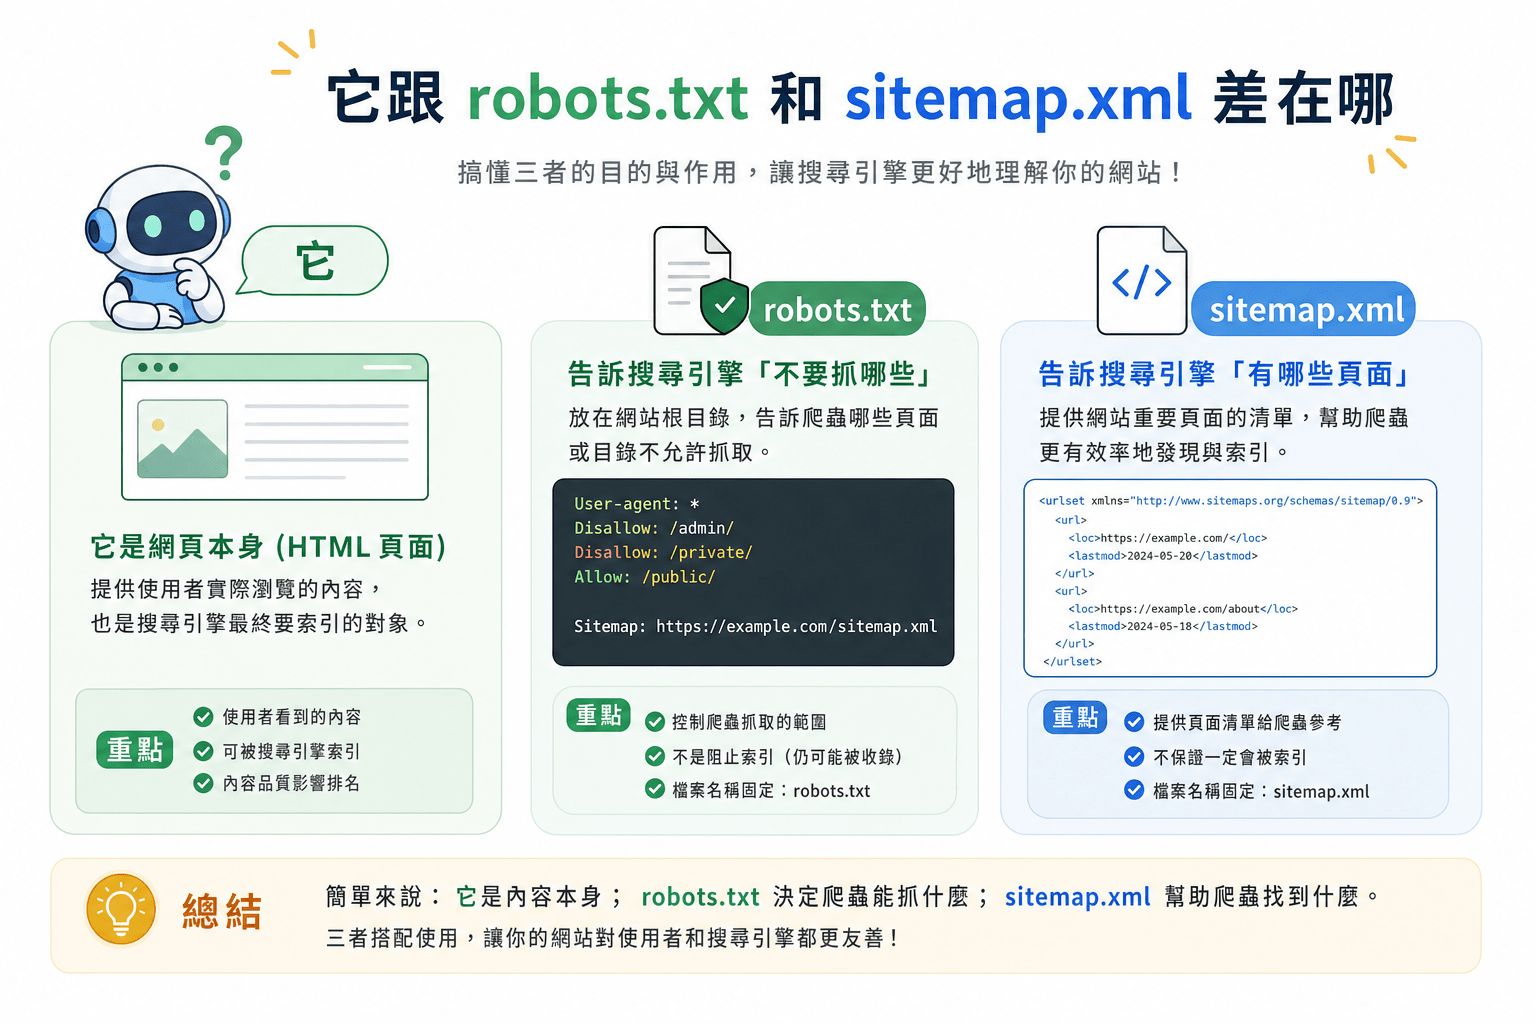
已經有 sitemap.xml 的網站還需不需要 llms.txt,要看期待它解決哪一種問題,三個檔案的分工可以先對照一次。
| 檔案 | 讀的對象 | 內容 | 強制性 |
|---|---|---|---|
| robots.txt | 搜尋引擎與爬蟲 | 可不可以抓 | 業界標準,爬蟲通常遵守 |
| sitemap.xml | 搜尋引擎 | 網站有哪些頁 | Google 官方支援 |
| llms.txt | 大型語言模型 | 重要內容是哪些,在講什麼 | 社群提案,沒有 AI 公司公開承諾 |
llms.txt 想做的事比 sitemap.xml 多一層,sitemap.xml 列的是網站有哪些頁,llms.txt 要把脈絡一起交出去,用摘要與分類讓模型比較容易拿到對的素材。
AI 公司真的會讀 llms.txt 嗎
動手前最該面對的就是這一題,到目前為止沒有任何主流 AI 公司公開承諾會讀 llms.txt,OpenAI、Anthropic、Google、Perplexity 的爬蟲文件(GPTBot、ClaudeBot、Google-Extended、PerplexityBot)都沒有提到它。
做了 llms.txt 之後,短期內很難期待 ChatGPT 因此多引用一次,它的價值偏向兩件事,一是替可能出現的標準先準備,二是做這份檔案會把內容結構重新整理一遍。有人保證放了 llms.txt 就會被 AI 引用,那跟保證排名第一是同一種話術。
哪些網站該做 llms.txt?我們給客戶的判斷
這件事不必每個網站都花力氣,我們接觸的客戶大致分成三種情況。
- 建議做:內容量在 50 篇以上、主題分類明確、希望對模型表達一份內容地圖,而且每季維護一次的人力排得出來。這類網站就算現在沒被讀,也等於把內容盤點做了一遍。
- 可以晚點做:中型的內容網站,但 SEO 與 AI 搜尋 的基本功還沒做穩。資源先補基本功,llms.txt 排在後面。
- 現在不必做:純服務型網站,頁數在 20 以下,也沒有部落格或知識中心。對模型表達「重要內容在哪」對這類網站幫助有限,llms.txt 也不會讓它被提到沒服務過的領域。
判斷的原則只有一句,llms.txt 屬於基本功做完之後的加分項,順序倒過來通常是把資源花在見效最慢的地方。
llms.txt 長什麼樣子?最小範例
llms.txt 用 Markdown 寫,結構固定而且極簡,完整提案在 llmstxt.org,實務上一份能用的版本不會太長。
結構上開頭用 H1 寫網站名稱,接一段引文說明這個網站在做什麼,下面再用 H2 分區,例如知識文、案例、服務。每一區用條列列出重要頁面,每一條的寫法是連結加上一句摘要,最後可以放一個 Optional 區,放次要、可選讀的內容。
格式不難,難的是摘要寫得夠不夠精準,模型去讀的時候那一句摘要決定它要不要採用這個來源。寫成 meta description 那種模板腔價值就低,寫成「這篇講某個做法的實際步驟,以及我們從幾個案例看到的誤區」才有用。
llms.txt 怎麼動手做:五個步驟
判斷之後決定要做,下面的順序是我們實際操作時的做法,前一步的產出就是後一步要用的素材。
- 內容盤點:列出網站上希望被模型拿去當答案素材的頁面,通常落在 30 到 80 個。挑的是精選,全部頁面放進去沒有意義,資訊型、How-to、深度知識文優先,純行銷頁排後面。
- 為每一頁寫一句摘要:寫明這頁在解決什麼問題、有什麼獨特的觀點。這一步最花時間,llms.txt 的價值也幾乎都在這裡。
- 分組與排序:用 H2 分成三到五個主題類別,每一類放最重要的五到十條,重要的往上,邊緣的往下或移到 Optional。
- 部署到根目錄:檔案放在
/llms.txt,不要放子目錄。提案裡還有一份/llms-full.txt,含完整內文供模型直接讀,維護成本高,多數網站做基本款就夠。 - 標上更新時間:檔案開頭或結尾寫上
Last updated與日期,格式用 YYYY-MM-DD。模型如果真的在讀,會偏好新鮮的資訊。
關於 llms.txt 的三個誤解
第一個誤解是把 llms.txt 當成保護內容不被 AI 學習的工具,它沒有這個功能,要控制爬蟲的存取得回到 robots.txt,針對 GPTBot、ClaudeBot 這些寫規則,再搭配 結構化資料(Schema) 把內容標記清楚。
第二個誤解是把整個網站都放進去,所有頁面全塞進 llms.txt 等於沒有重點,模型反而抓不到最重要的那幾篇,精選才是這份檔案的作用所在。
第三個誤解是做完就不再維護,網站的內容會更新,也會新增與下架,llms.txt 沒有同步就會把模型導向已經下架或過時的頁面。每季維護一次是合理的頻率,排不出這個人力,建議先不要做。
llms.txt 對 SEO 與 GEO 有什麼影響
直接的影響很有限,llms.txt 本身不會提升搜尋排名,Google 的演算法目前沒把它當訊號,對 GEO(生成式引擎優化) 的影響也還沒有被驗證,因為沒有 AI 公司宣告會讀。
間接的那一面可能比直接的大,做這份檔案會迫使網站重新回答一個問題,哪幾篇內容才是最值得被引用的。這個盤點對整體的 AI + SEO 規劃有用,順手做可以,當成優先項目就不合適。
結論:基本功先做穩,llms.txt 當加分項
收斂成幾句話,llms.txt 是有意思的社群提案,目前沒有 AI 公司承諾會讀,它能提供結構化的指引,但不會自動帶來引用。資源有限的時候,先把 SEO 與 GEO 的基本功做穩,再把它當加分項。內容量大、主題明確的網站做了不虧,服務型或頁數少的網站暫時不做也沒有差別。
不確定自己的網站該不該做 llms.txt,或者想順便把內容盤點做掉一次,都可以點下方按鈕聯繫,也可以走 聯繫表單。里揚會先看過內容結構與現有的 SEO 狀況再給建議。
llms.txt 常見問題 FAQ
做了 llms.txt,ChatGPT 真的會讀嗎?
目前沒有任何主流 AI 公司公開承諾會讀,OpenAI、Anthropic、Google、Perplexity 的爬蟲文件都沒有提到它。它是社群提案,還沒成為業界標準。做它的意義偏向替可能出現的標準先準備,以及順便把內容盤點做一次。
llms.txt 跟 robots.txt、sitemap.xml 可以只做一個嗎?
三者的目的不同,沒辦法互相取代,robots.txt 管爬蟲的權限、sitemap.xml 提供頁面列表給搜尋引擎、llms.txt 給語言模型一份精選加上脈絡的重要內容清單。前兩個是業界標準要做,llms.txt 屬於可選的加分項。
什麼樣的網站不必花力氣做 llms.txt?
純服務型,頁數在 20 以下,也沒有部落格或知識中心的網站。這類網站能交給模型的素材本來就不多,資源先放在 SEO 基本功與商業意圖的頁面比較實在。
llms.txt 會影響搜尋排名嗎?
不會,Google 的演算法目前沒把 llms.txt 當排名訊號,它的價值在於可能讓模型更容易理解網站的內容結構,以及做這份檔案時順便完成的內容盤點對整體規劃有幫助。把它當 SEO 工具用是沒有效果的。